今天,我们上线并开源 GLM-5.3-Flash (320B-A18B),这是 GLM-5 系列的首个原生多模态模型。
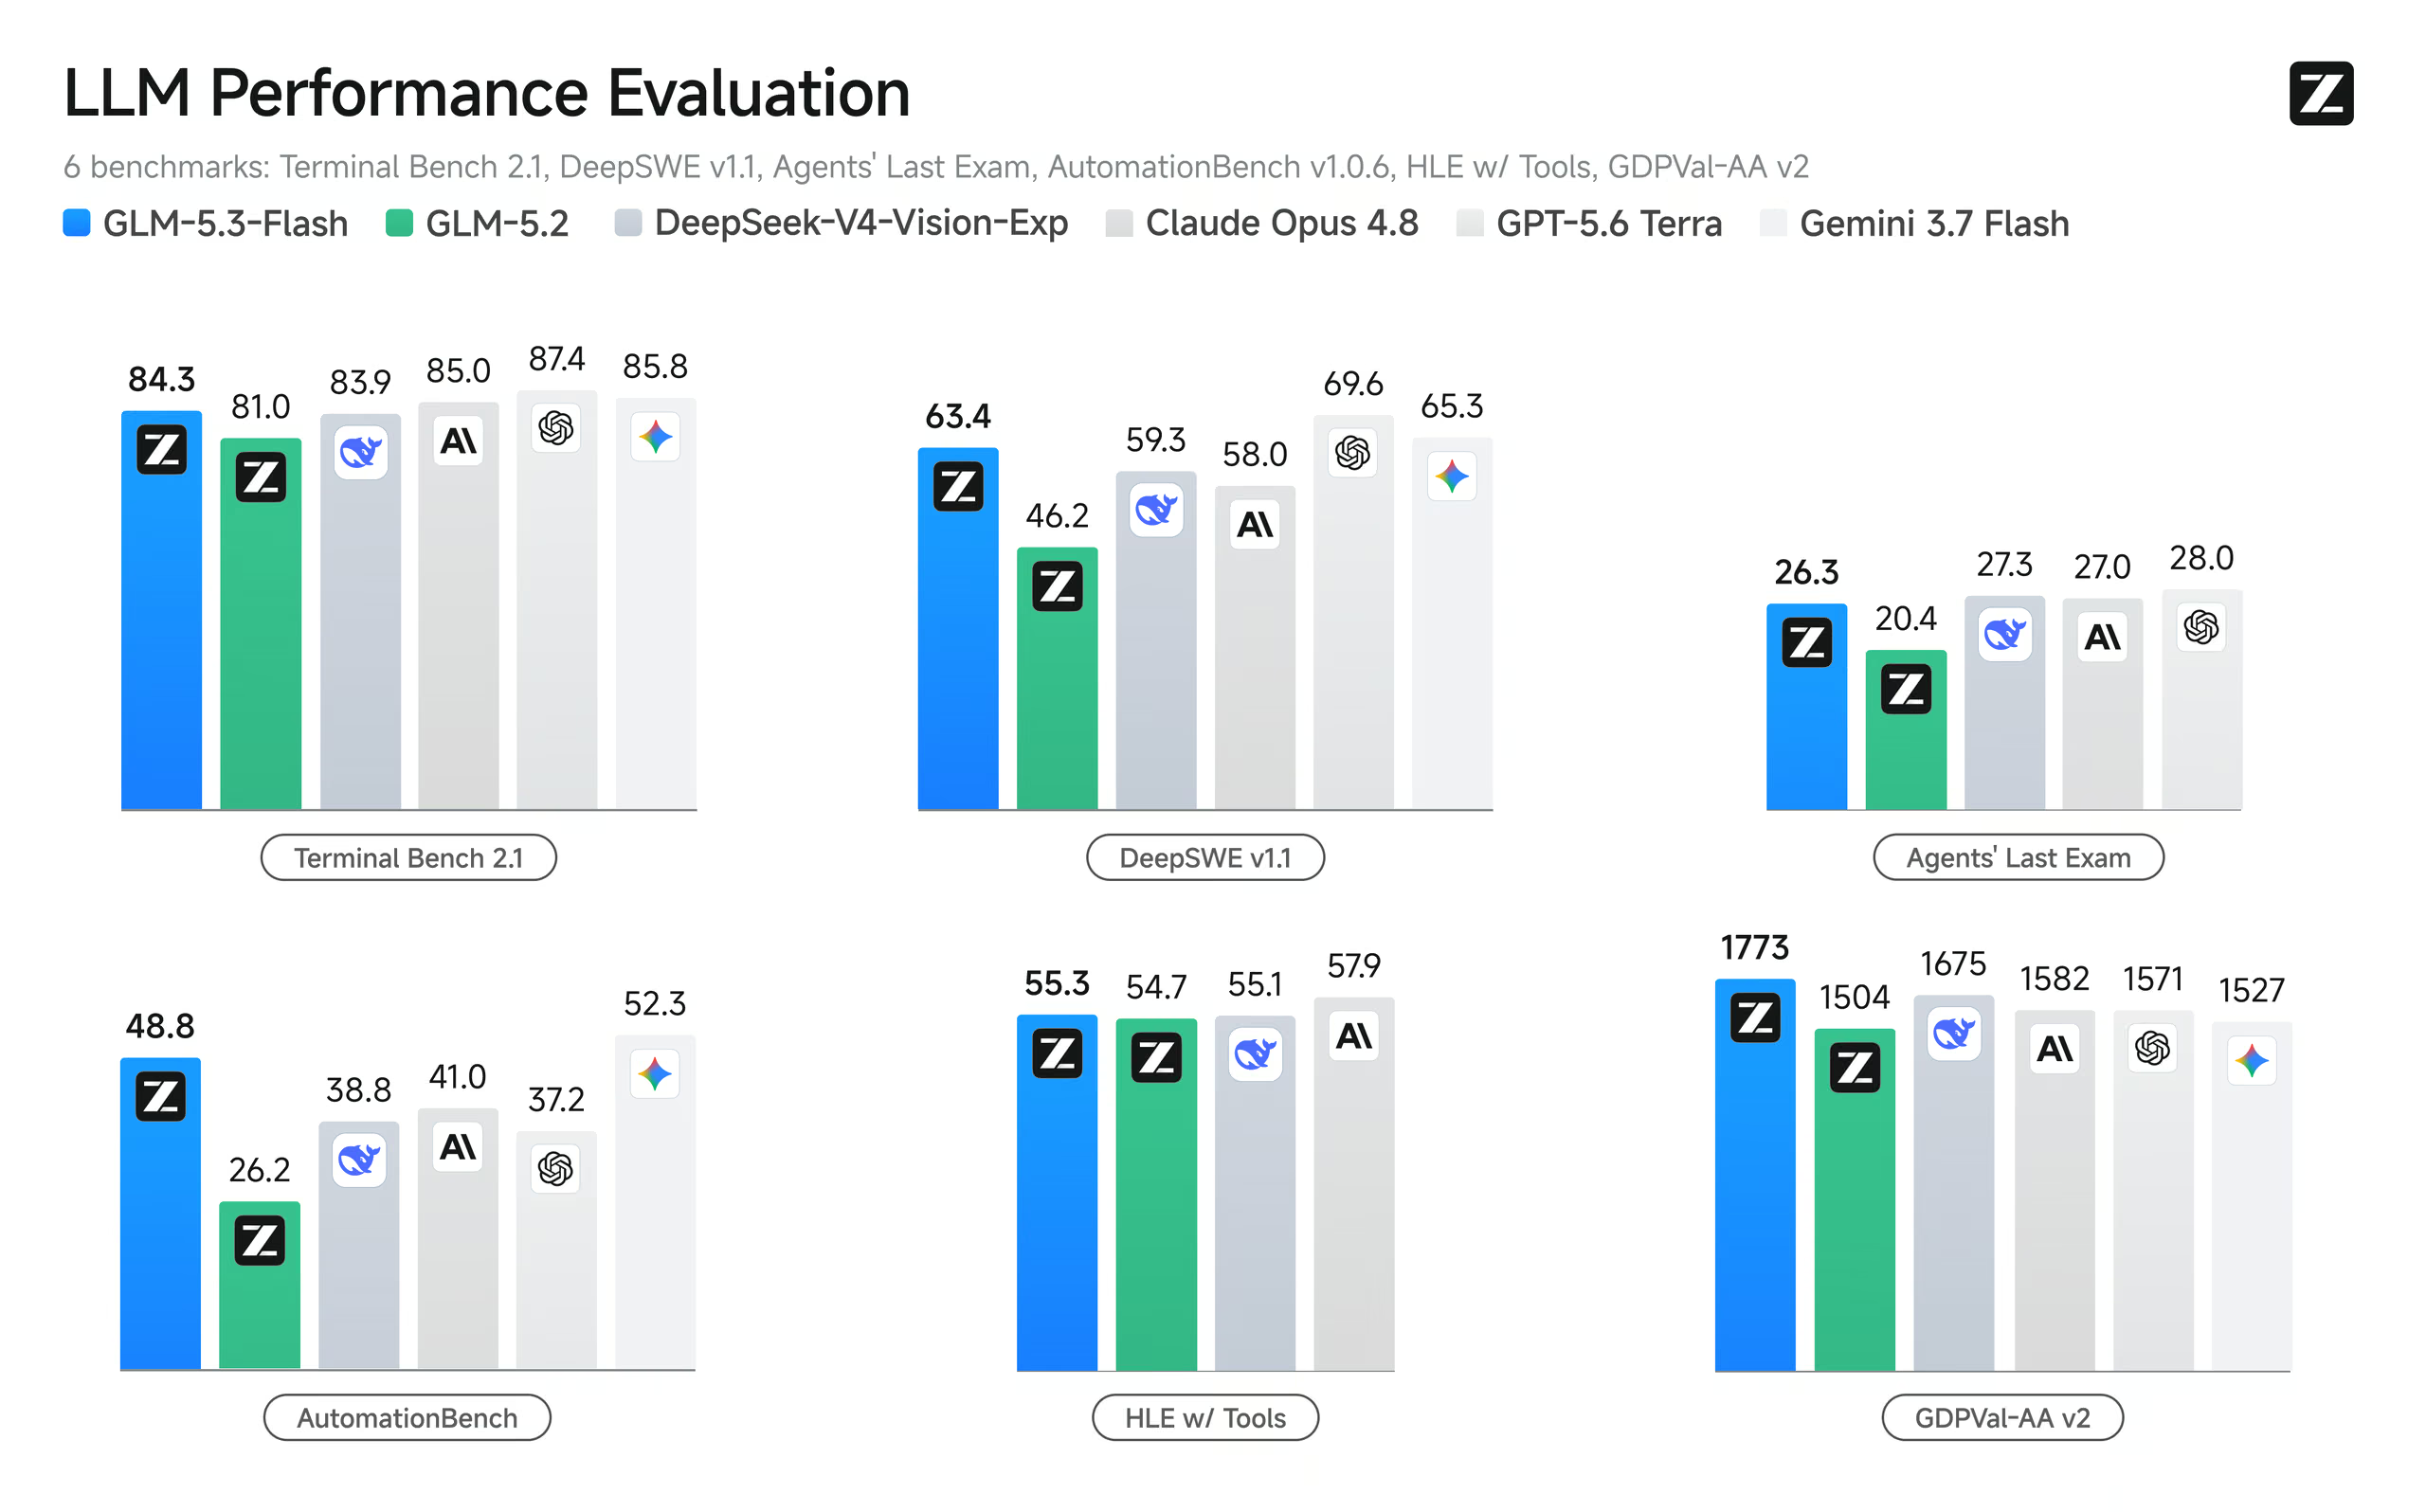
大家好像已经习惯将前沿智能与前沿价格绑定,并认为这是技术进步必须支付的成本。今天,GLM-5.3-Flash 来了:320B 总参数,能力超过 GLM-5.2,在全球权威的 Artificial Analysis Intelligence Index(AA 综合智能指数)中取得 57 分,进入全球前沿模型能力区间,与 Anthropic 最受欢迎的模型 Claude Opus 4.8 得分持平。在自研 Z.ai Code Bench 体感评估中,其编程表现与 Claude Opus 4.8 相当。
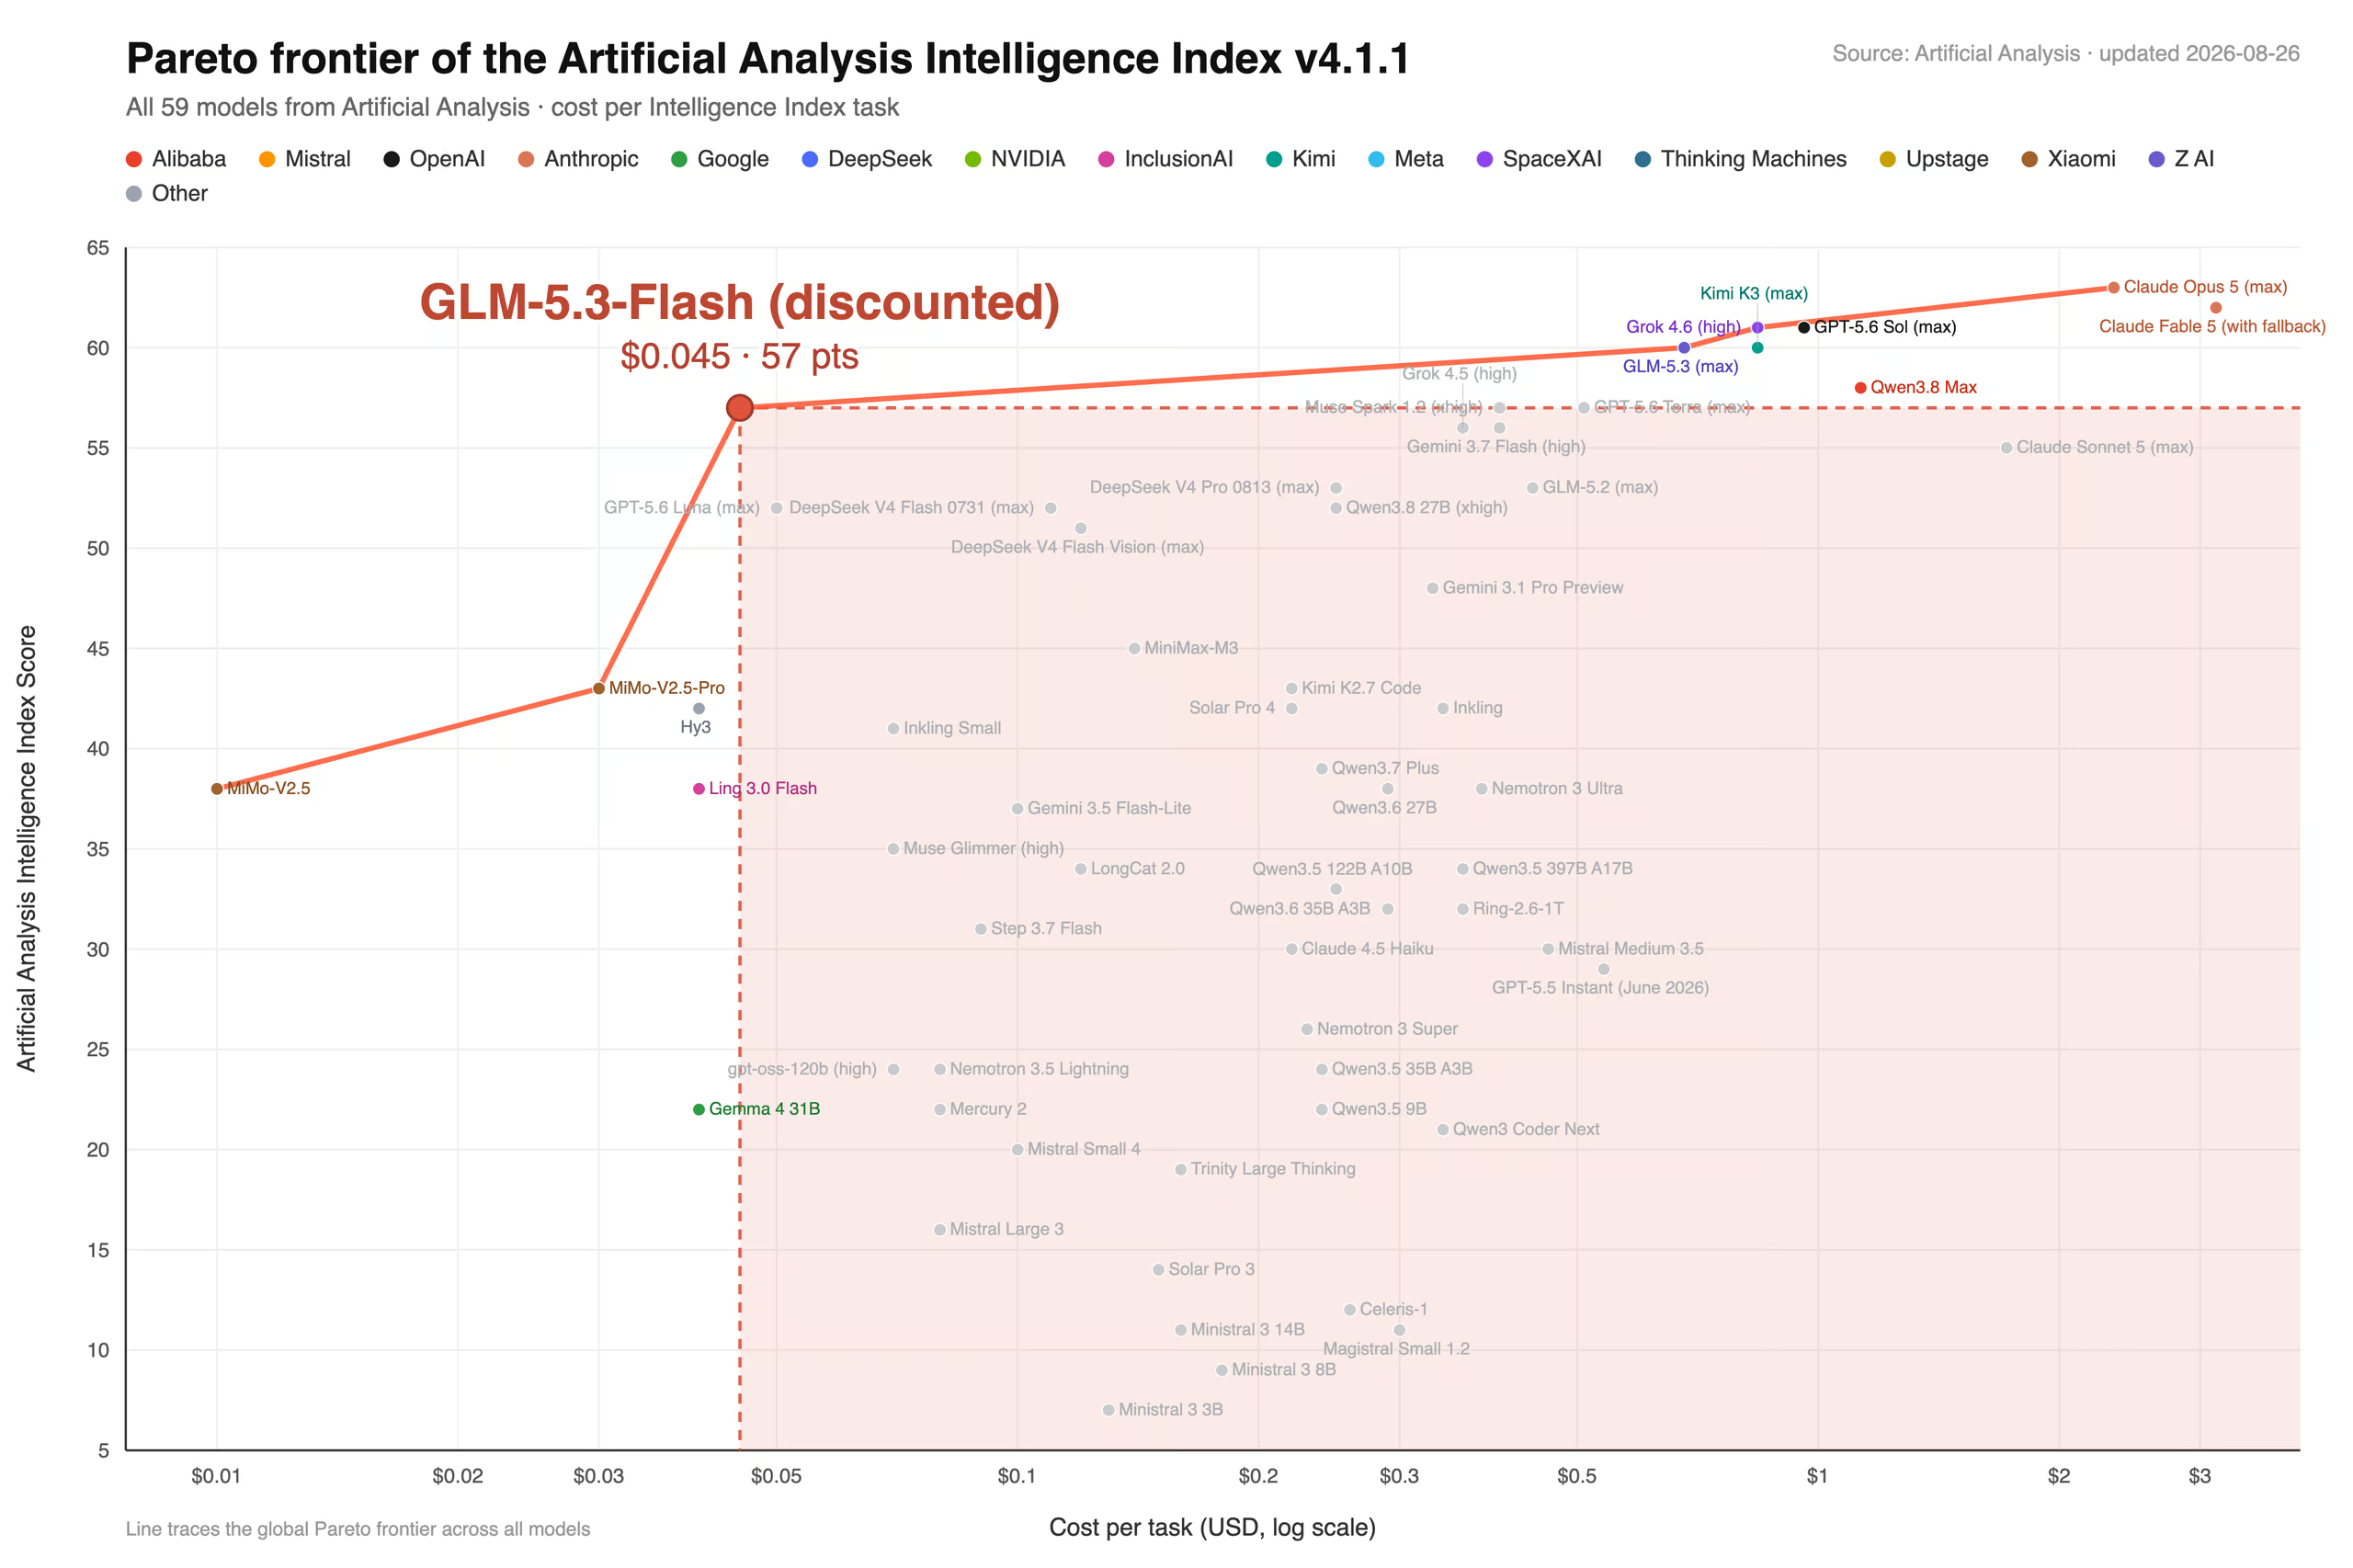
与此同时,GLM-5.3-Flash定价为 GLM-5.3 的 1/10,限时折扣内为 GLM-5.3 的 1/20,为 Opus 4.8 的 1/40。同样智力,1/40 价格,前沿智能,第一次不需要省着用。
为收集广大用户的广泛、专业反馈,我们在正式发布前,以匿名模型 Ox-Alpha(中文社区称作牛来)在 OpenCode 和 OpenRouter 上进行了大规模测试。Ox-Alpha 迅速成为当周最受欢迎的模型,创下双平台调用量新高。而这些请求流量全部由国产芯片提供算力支持。
GLM-5.3-Flash 在各项基准测试和实际使用中,全面超越参数量高出一倍的 GLM-5.2,定价却仅为 GLM-5.3 的 1/10。这得益于其全新模型架构。GLM-5.3-Flash 的架构专为极低成本而设计,总参数量与 GLM-4.5 相当(355B vs. 320B),但激活参数量(32B → 18B)与层数(92 → 45)几乎减半。结合我们最新的 30T Token 多模态预训练语料,GLM-5.3-Flash 能够以更少的计算资源实现更强的性能。
GLM-5.3-Flash 同时进行了多项架构升级,是首个采用稀疏注意力与线性注意力混合架构的开源前沿模型,在保持精准长上下文能力的同时,大幅降低长上下文服务成本;并采用流形约束超连接(Manifold-Constrained Hyper-Connections,mHC)提升模型 Scaling 能力。具体技术细节见 Blog:https://z.ai/blog/glm-5.3-flash。
极致低成本架构
为降低模型长上下文场景下的注意力成本,我们采用线性注意力与稀疏注意力相结合的混合架构。其中,线性注意力通过递归机制捕获局部依赖关系,稀疏注意力则借助轻量级索引器召回全局上下文。我们引入 IndexPool 为进一步降低 1M 上下文下索引器的时延与内存开销,通过加权池化将索引器的 4 个缓存向量压缩为 1 个。
为展示架构效率,我们将 GLM-5.3-Flash 与 GLM-5.3、DeepSeek-V4-Flash 和 Kimi-K3 进行对比,重点考察单 Token 计算量和 KV 缓存大小。为公平比较不同规模的模型,我们分别展示每个 Head、每层注意力计算量,以及每层平均 KV 缓存大小(BF16)。相较于 GLM-5.3,GLM-5.3-Flash 的注意力计算量与 KV 缓存大小分别降低了 3.01 倍和 4.44 倍。
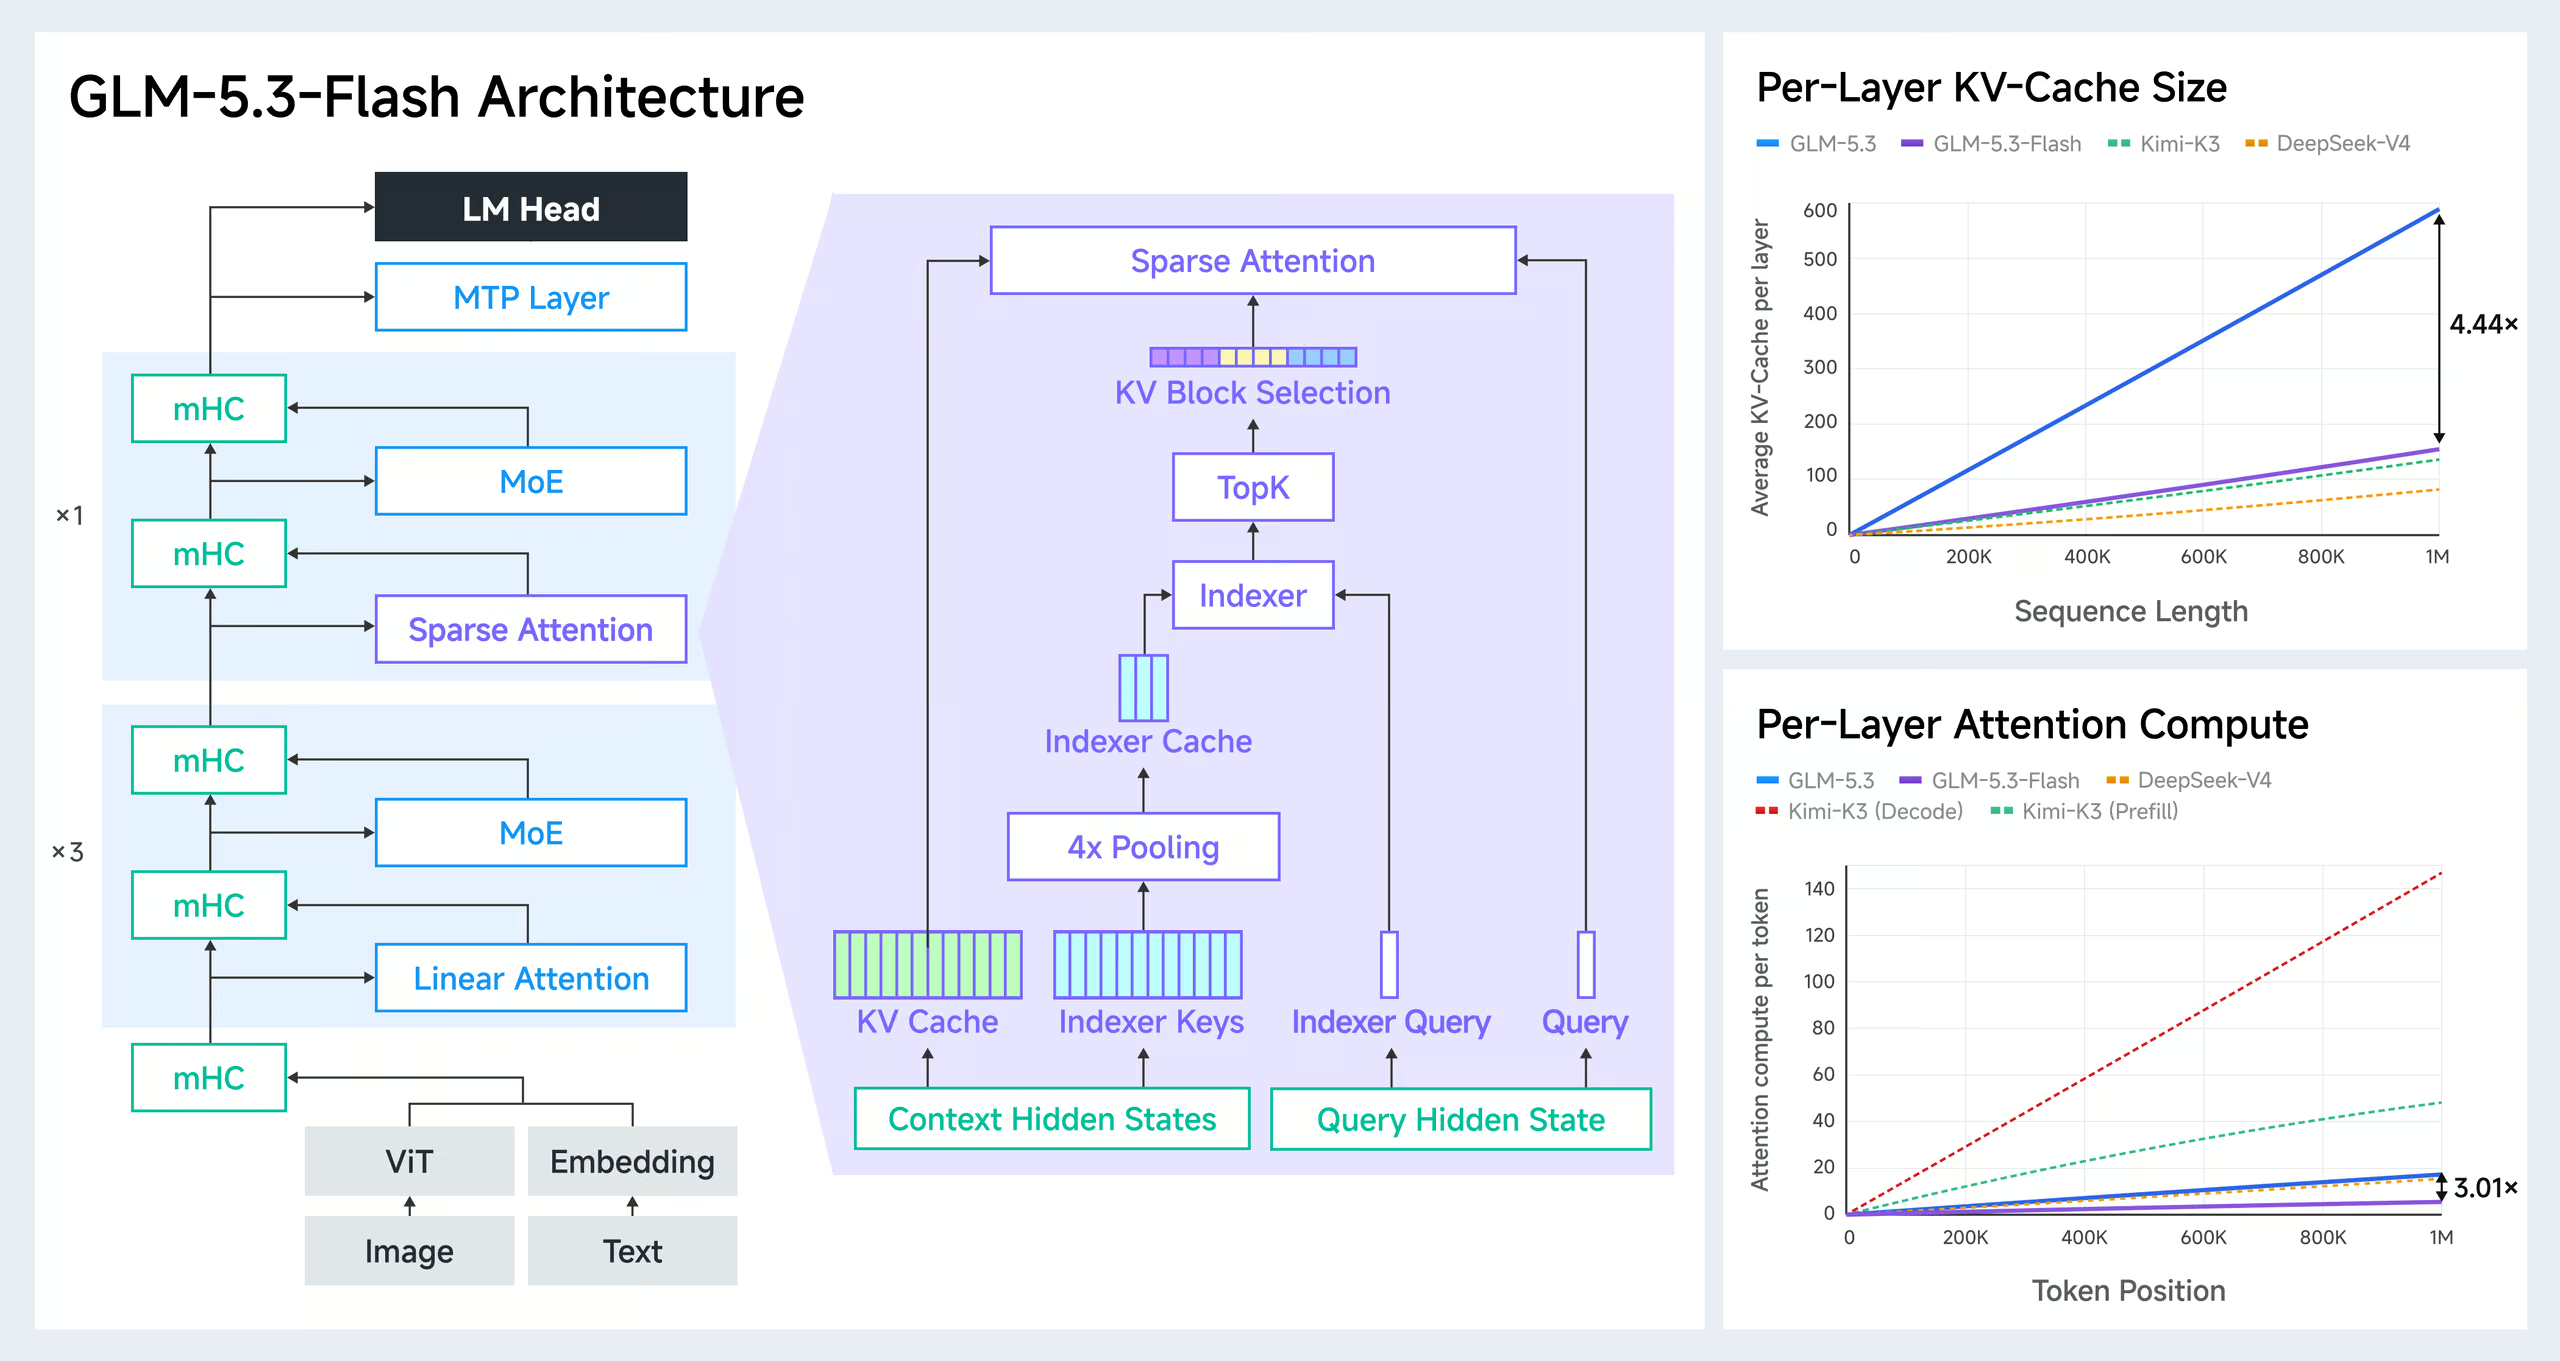
在所有基线模型中,GLM-5.3-Flash 的注意力计算量最低。不过其 KV 缓存大小仍略高于 Kimi-K3 和 DeepSeek-V4-Flash,这也是我们在后续工作中进一步优化的方向。
代码循环中的视觉反馈
GLM-5.3-Flash 是 GLM-5 系列的首个原生多模态模型。视觉编码(Visual Coding)并不只是处理图像,它拓展编程所能触及的边界。对于前端开发、游戏开发、3D 仿真等任务而言,最终产物包括用户能够感知的界面、交互或虚拟世界,视觉能力被原生集成进模型中,使其能够自主判断何时需要“观察”,并利用视觉反馈来指导下一步行动。
我们针对视觉编码开发了数据合成流水线,重点聚焦于模型的自我视觉判断与测试时改进。最终生成的轨迹要求模型与环境交互、检视自身输出,并进行迭代式改进。在前端 Coding 方面,我们还探索基于环境反馈的强化学习,并通过基于真实用户流程的 Agent 验证,进一步强化 GUI 判断能力。这将验证的范畴从功能正确性延伸至渲染效果与交互体验层面。
令人意外的是,Coding 为模型提供了一种表达并检验其世界知识的代理。在 Blender 中构建一个连贯的场景,需要将几何、材质、光照与空间等知识转化为一个在不同视角下都保持一致的 3D 结构。在没有任何外部素材的情况下,GLM-5.3-Flash 自主运行 16 个小时搭建了一套约 400 平方米的专业主厨自宅与测试厨房。
在 ZCode 中,Browser Use Agent(BUA)与 Computer Use Agent(CUA)进一步拓展多模态能力,使模型能够在代码、浏览器与图形界面之间协同工作,同时观察并验证自身的输出结果——许多问题只有在渲染、交互或试玩过程中才会暴露出来。以下是在 ZCode 中使用 GLM-5.3-Flash 实测合集:从图像到可运行工程,从两小时电影到 8 分钟成片,以及可直接交付的白领专业文档。
超越Coding的工作伙伴
GLM-5.3-Flash 在专业工作中的表现相较同级别模型显著提升。针对 PPTX、PDF、DOCX 和 XLSX 等 Office 与文档类任务,新增的视觉理解能力使模型能够检查并优化自身输出,并具备更强的审美判断。模型还可以将自己的输出结果与视觉上下文以及预期的结果进行对比,从而实现更有效的自我验证和优化——包括更准确的呈现质量评估以及审美判断。
我们专门针对金融、法律等专业工作进行优化。在金融方面,GLM-5.3-Flash 可以覆盖从基于来源的金融研究、报告生成到金融建模与分析的完整流程,在整个过程中提供可追溯的参考依据。在法律方面可以审查合同中的费用、账户与责任条款,并按律师惯例批注留痕。它也能起草律师函、合同与诉讼文书,格式与版式符合实务规范,生成即可交付。
金融研报 · 业绩点评
法律文书 · 合同批注修订
跑在国产芯片上
过去一周,我们首次在大规模流量中尝试用大国产芯片集群提供服务,这些芯片通过自研高带宽互联网络连接。
为克服单张芯片算力与内存容量相对有限的问题,我们在 SGLang 基础上构建了专用的推理引擎。值得一提的是,整个构建工作由 GLM-5.3 驱动的 infra agent 大大加速,它协助工程师开发与优化算子、诊断性能瓶颈、改进部署服务栈,形成了“模型优化系统,系统承载模型”的正向循环。
这些芯片主要瓶颈在于内存容量与带宽,尤其是支持长达 1M 上下文长度很有挑战。这要求我们针对底层架构进行激进的内存优化,包括以算力换带宽、以通信换显存等定制优化。我们的技术栈结合了用于线性注意力和 LM head 的节点内张量并行、ReplaySSM、W8A8 量化、INT8/FP8/BF16 混合缓存量化,以及 Layer Split 等技术。
在集群层面,我们采用生产级 Encode–Prefill–Decode(EPD)分离式架构,将多模态编码、prompt 预填充和逐 token 解码拆分为可独立调度、独立扩缩容的工作池,从而在国产加速芯片上实现了高效、可靠的服务。
与同一硬件上的初始基线相比,端到端服务性能提升了 3 倍,硬件效率和单 token 成本已达到与主流英伟达 GPU 相当的水平。这证明国产芯片完全可以在大规模场景下高效、经济地支撑前沿模型的推理需求。
现在,GLM-5.3-Flash 正式面向全球开源,已接入 ZCode 等编码平台,并纳入 GLM Coding Plan(每天限量发放 10,000 张体验卡),同步开放 API 调用。
1. 官方 API 接入
- BigModel 开放平台:https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash
- Z.ai:https://docs.z.ai/guides/vlm/glm-5.3-flash
- GLM Coding Plan:https://bigmodel.cn/glm-coding
2. 在线体验
- Z.ai:https://chat.z.ai
- 智谱清言 App:https://chatglm.cn
3. Agent
- ZCode(代码工具):https://zcode.z.ai/cn
- AutoClaw(办公场景):https://autoclaw.zhipuai.cn